Перейти к CVmap
average®

average

Прокрутите, чтобы войти

Исследовательская визуализация людей в производственном цехе

CVmap

Видеть.
Понимать.
Действовать.

Система видеоаналитики производства: детекция людей, multi-object tracking, spaghetti tracking, ReID, тепловые карты, события пересечения линий, анализ зон и сменные отчёты.
Красная пористая мембрана из вычислительных символов

MOSS / macOS / R&D

MOSS

Понять, что нужно сделать.
До следующего запроса.

MOSS — проактивный AI-ассистент для macOS, построенный вокруг непрерывного анализа пользовательской активности.

SONAR

У каждого голоса
своя линия.

Система обработки телефонных разговоров: ASR, diarization, speaker identification и LLM-анализ. Распознаёт речь, определяет участников, проверяет содержание по заданным критериям и формирует отчёты с привязкой к исходному аудио.

Но таких продуктов вот на нашем рынке я не видел

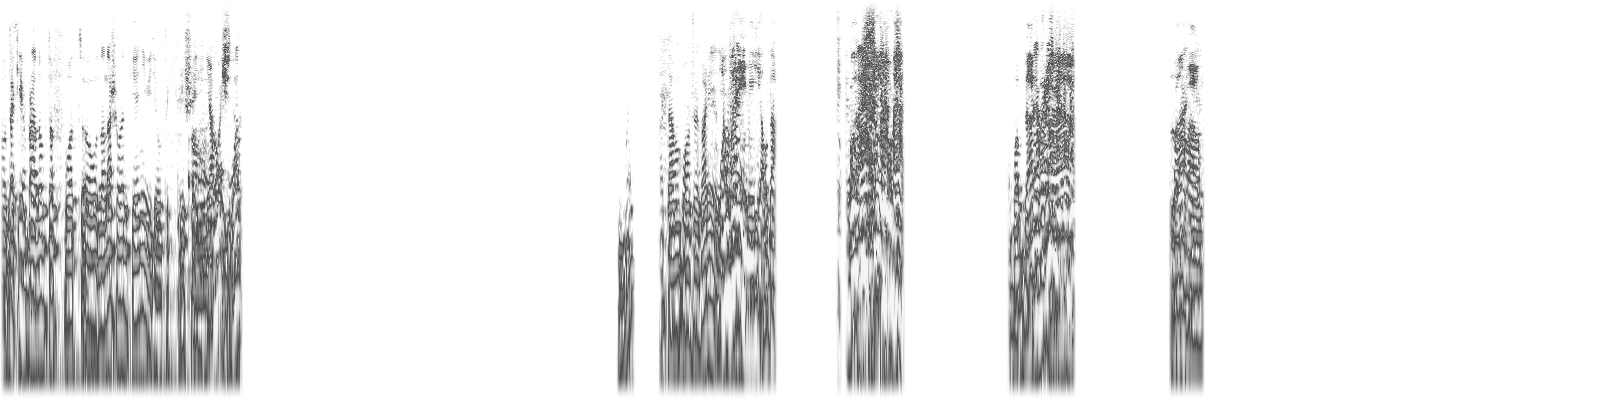
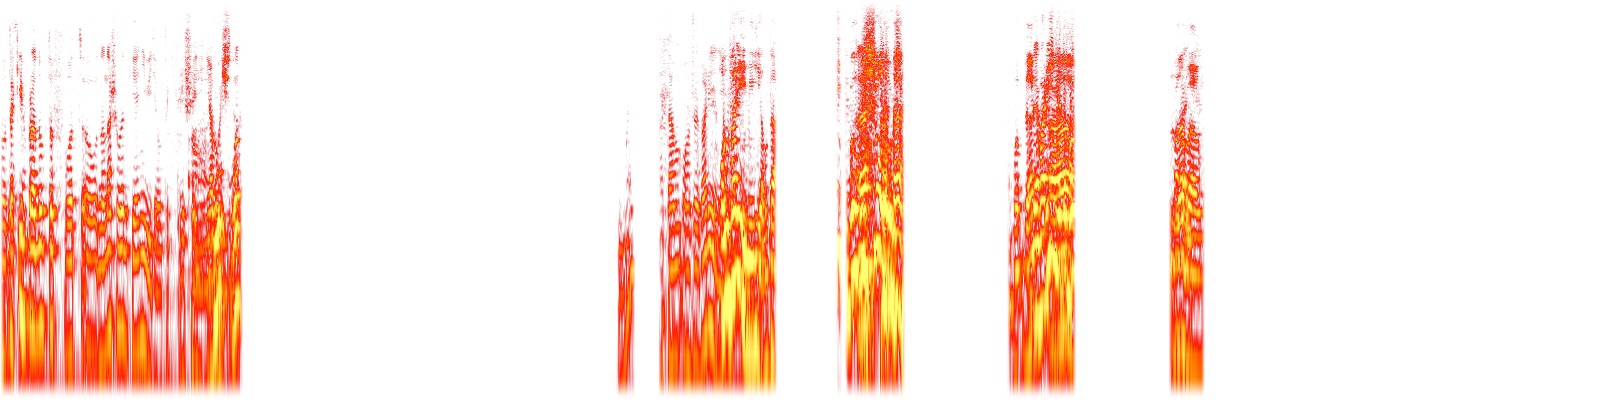
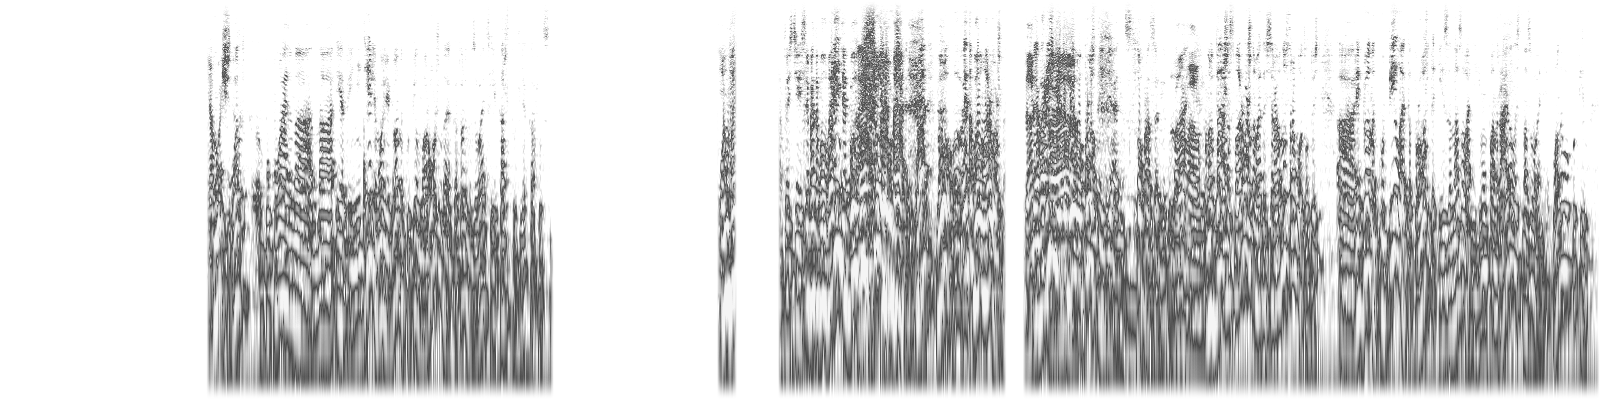
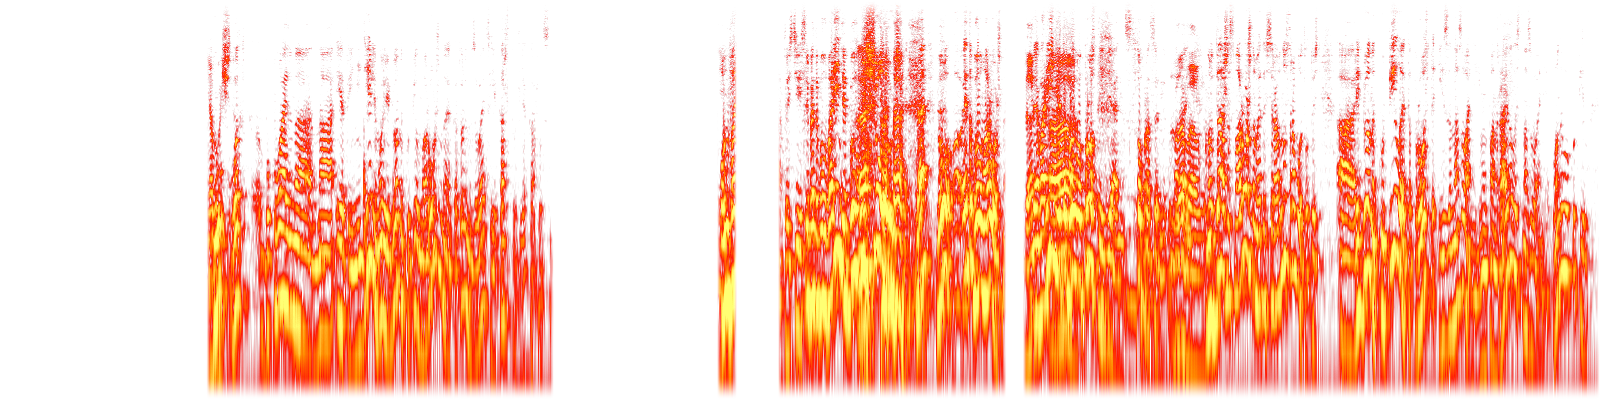
Спектрограмма в интервалах речи: голос 1
Спектрограмма в интервалах речи: голос 2
Голос 1Голос 2
СильнееТише

ATLAS

Найти смысл. Даже без совпадения слов.

Локальный поисковый движок на Rust: полнотекстовый и семантический поиск по корпоративным файлам, SQLite FTS5, векторный индекс и серверный inference на EmbeddingGemma 2. Поддерживаются офисные документы, PDF и мультимедийные материалы.
01Запрос

[
… ]
Упаковка 6937
6937.jpg
Упаковка 7119
7119.jpg
Упаковка 7812
7812.jpg
Упаковка 7815
7815.jpg
Упаковка 7816
7816.jpg
Упаковка 7818
7818.jpg
Упаковка 7820
7820.jpg
Упаковка 7919
7919.jpg
Упаковка 7925
7925.jpg
Упаковка 7942
7942.jpg
Упаковка 8135
8135.jpg
Упаковка 8137
8137.jpg
Упаковка 8346
8346.jpg
Упаковка 8370
8370.jpg
Упаковка 8500
8500.jpg
Alice in Wonderland excerpt 1
book-11-01.pdf
Alice in Wonderland excerpt 2
book-11-02.docx
Alice in Wonderland excerpt 3
book-11-03.txt
Alice in Wonderland excerpt 4
book-11-04.pdf
Alice in Wonderland excerpt 5
book-11-05.docx
Alice in Wonderland excerpt 6
book-11-06.txt
Alice in Wonderland excerpt 7
book-11-07.pdf
Alice in Wonderland excerpt 8
book-11-08.docx
Alice in Wonderland excerpt 9
book-11-09.txt
Alice in Wonderland excerpt 10
book-11-10.pdf
Alice in Wonderland excerpt 11
book-11-11.docx
Alice in Wonderland excerpt 12
book-11-12.txt
Sherlock Holmes excerpt 1
book-1661-01.pdf
Sherlock Holmes excerpt 2
book-1661-02.docx
Sherlock Holmes excerpt 3
book-1661-03.txt
Sherlock Holmes excerpt 4
book-1661-04.pdf
Sherlock Holmes excerpt 5
book-1661-05.docx
Sherlock Holmes excerpt 6
book-1661-06.txt
Sherlock Holmes excerpt 7
book-1661-07.pdf
Sherlock Holmes excerpt 8
book-1661-08.docx
Sherlock Holmes excerpt 9
book-1661-09.txt
Sherlock Holmes excerpt 10
book-1661-10.pdf
Sherlock Holmes excerpt 11
book-1661-11.docx
Sherlock Holmes excerpt 12
book-1661-12.txt
Найденная упаковка
Лучшее совпадение

6937.jpg

ARGUS 01

Изображение из поиска

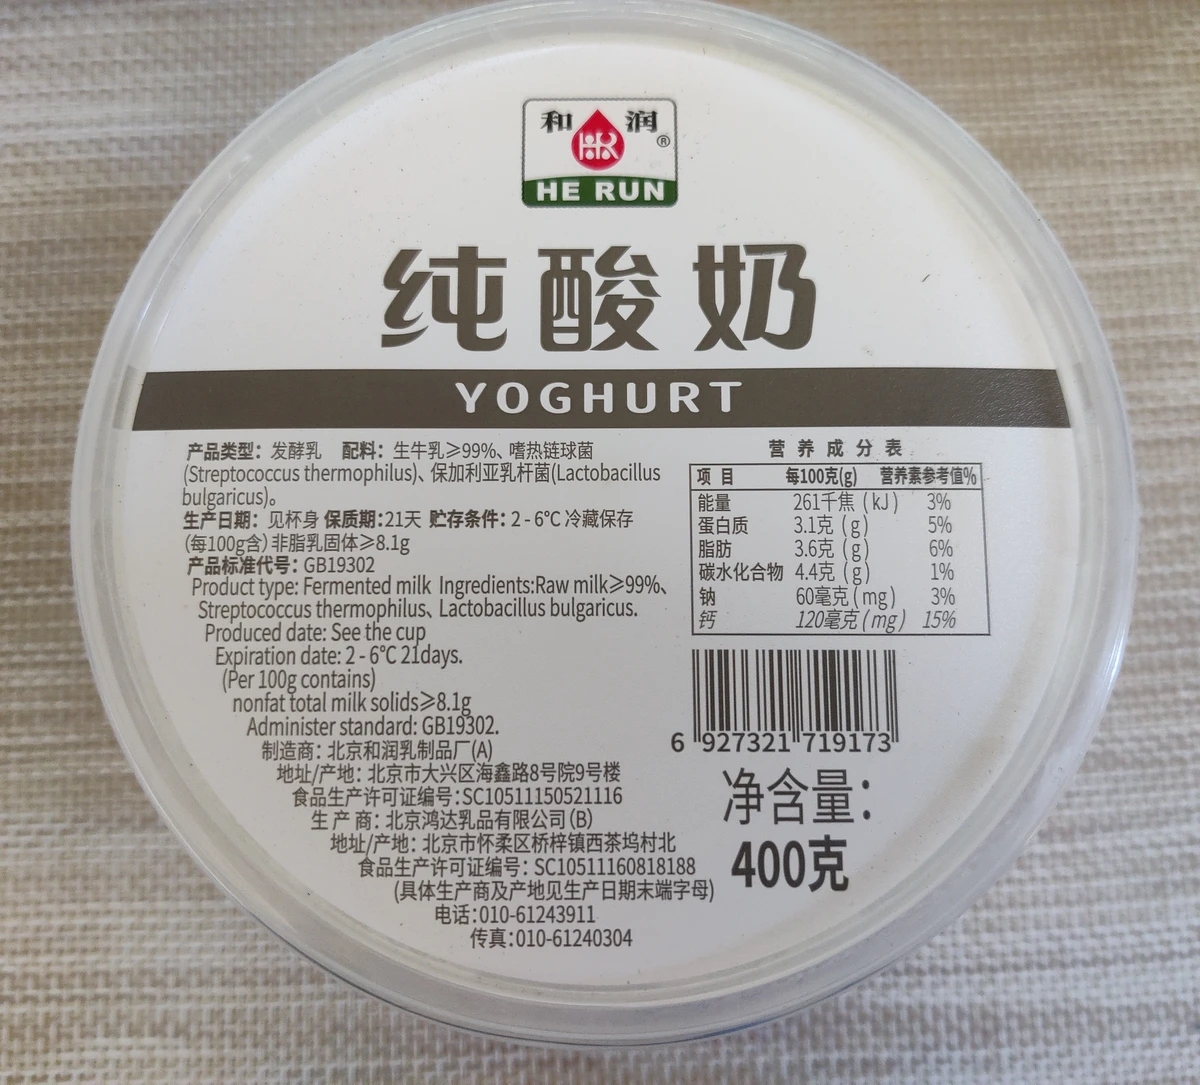
Английская строка ошибочно называет температуру хранения и срок годности датой окончания срока годности. Китайская строка указывает срок 21 день и хранение при 2–6 °C отдельно.

06 / ТАБЛИЧНЫЙ ИНТЕЛЛЕКТ

FORMA

Из контекста —
в решение.

ML-система для подготовки технологических карт флексопечати. По данным заказа из 1С пять моделей на TabICLv2 и CatBoost подбирают станции печати, анилоксы, монтажные ленты и ракельные камеры.

AVERAGE® — СОТРУДНИЧЕСТВО

AI / ML Engineering 2026

Теперь — ваша задача.

ЧЕМ МОГУ БЫТЬ ПОЛЕЗЕН

01 /

Технический аудит

Оценка архитектуры, данных, метрик и ограничений ML-систем.

02 /

Сопровождение

Независимая экспертиза разработки, экспериментов и технических решений.

03 /

Разработка AI/ML

От исследования и baseline до production-интеграции.

Подробнее о сотрудничестве

Сотрудничество

Технический аудит AI/ML-проектов

Провожу независимый разбор ML-систем: постановка задачи, данные, разметка, архитектура, метрики, inference и инфраструктура.

Помогу оценить обоснованность технических решений, найти ограничения текущего подхода и определить, какие эксперименты действительно стоит проводить. Особенно интересны случаи, когда хорошие offline-метрики расходятся с качеством на реальных данных.

Техническое сопровождение разработки

Могу подключиться со стороны заказчика: обсуждать архитектуру с подрядчиками, проверять реализацию, оценивать эксперименты и технические риски, участвовать в приёмке.

Это полезно, если проект требует независимой AI/ML-экспертизы, а собственного специалиста внутри компании нет.

Разработка AI/ML-систем

Беру задачи от исследования и baseline до inference-сервиса, интеграции и интерфейса. Основные направления — computer vision, табличный ML, speech, retrieval и LLM-агенты.

Предпочитаю начинать с измеримого эксперимента: определить критерии успеха, собрать baseline, сравнить варианты и только после этого масштабировать выбранное решение.


Есть сложная задача?

Если разрабатываете AI/ML-продукт, хотите проверить существующую архитектуру или ищете инженера для исследовательской задачи — напишите мне.

Можно сразу прислать репозиторий, описание проблемы, примеры данных или результаты текущих экспериментов.

Telegram: @maintagg

Внутри вычисления

Реальный инференс

В основе визуализаций — реальные запуски ML-моделей. Во время обработки мы сохраняем результаты и промежуточные представления: признаки, векторы, активации и предсказания.

Эти данные позволяют заглянуть внутрь вычисления и проследить путь от входных данных до результата. Прокрутка управляет воспроизведением записанных состояний.

Технический разбор / Проактивная система

MOSS

Понять, что нужно сделать.

До следующего запроса.

Работа не начинается с сообщения ассистенту и не заканчивается закрытием диалога. Она продолжается между приложениями, документами, браузером и терминалом. Мы прерываем задачи, возвращаемся к ним спустя дни, переключаемся между проектами и редко объясняем компьютеру, зачем совершаем каждое действие.

Традиционный AI-ассистент видит запрос. MOSS пытается понять работу, которая ему предшествовала.

MOSS — проактивный AI-ассистент для macOS, построенный вокруг непрерывного анализа пользовательской активности. Вместо того чтобы ждать очередного сообщения, система связывает события в задачи, отслеживает их состояние и определяет, когда помощь может оказаться полезной.

В основе MOSS лежит механизм сегментации деятельности. Система анализирует разрешённые события операционной системы, контекст приложений и визуальную информацию, формируя последовательность наблюдений. Специализированная модель устанавливает, какие из них относятся к одной задаче, даже если пользователь переключается между совершенно разными приложениями.

Эти связи образуют TaskThread — сохраняемый контекст отдельной задачи. Он не привязан к одному окну, приложению или непрерывному отрезку времени. Задача может быть прервана, продолжена через несколько часов или возобновлена спустя месяц. MOSS связывает новую активность с существующим TaskThread либо обнаруживает появление нового.

Модель сегментации не обязана знать, как называется задача. Её основная функция — устанавливать принадлежность наблюдений. Семантическую интерпретацию, описание целей и работу с содержанием выполняет языковая модель, получая уже структурированный контекст.

Следующий уровень — проактивность. MOSS оценивает не только возможность помочь, но и уместность вмешательства. Система может подготовить информацию, предложить следующий шаг, обратить внимание на изменение обстоятельств или ничего не делать. Отсутствие действия здесь такое же допустимое решение, как инициатива.

Наблюдение за работой не означает права ею управлять. MOSS разделяет обнаруженные факты, предположения, рекомендации и разрешённые действия. Пользователь контролирует источники контекста и границы самостоятельности ассистента.

MOSS / macOS / BETA

Технический разбор

Нативный интерфейс

Клиент MOSS разработан для macOS с использованием SwiftUI. Интерфейс отображает текущие TaskThread, их историю, состояние и действия ассистента.

Взаимодействие не ограничивается чатом. Пользователь может вернуться к сохранённой задаче, просмотреть связанный контекст, принять или отклонить предложение, уточнить намерение и изменить разрешения. Чат остаётся одним из способов управления системой, но не её единственной точкой входа.

Сбор и представление активности

MOSS формирует поток наблюдений из разрешённых источников macOS: событий приложений, состояния окон, доступного текстового контекста и визуальной информации.

Вместо передачи всей истории пользовательской активности непосредственно в LLM система предварительно обрабатывает наблюдения и формирует компактные представления происходящего.

Обработка учитывает временные зависимости и изменения состояния. Отдельные клики, переключения окон и фрагменты содержимого становятся входными данными для распознавания более продолжительных процессов.

Сегментация задач и TaskThread

Центральный компонент MOSS — модель сопоставления пользовательской активности с динамическим множеством задач.

В отличие от классического классификатора с фиксированными категориями, система работает с TaskThread, которые появляются в процессе использования. Каждая задача содержит собственную историю наблюдений и представлений активности.

Новые сегменты сопоставляются с существующими TaskThread. Модель определяет, относится ли активность к известной задаче, указывает на появление новой или пока не позволяет сделать уверенный вывод.

Такой подход позволяет связывать действия из разных приложений, обнаруживать прерывания и восстанавливать принадлежность активности к задаче после длительного перерыва.

Сегментация не требует предварительного текстового описания задачи. Название и семантический контекст формируются отдельно.

Контекстная память

TaskThread служит единицей долговременной памяти MOSS.

Система сохраняет связи между наблюдениями, используемыми ресурсами, подтверждёнными решениями и текущим состоянием работы. Память разделяет фактические события, модельные предположения и информацию, явно предоставленную пользователем.

При возвращении к задаче MOSS восстанавливает релевантный контекст, а не начинает интерпретацию всей истории заново.

Языковая модель получает отобранную информацию о задаче и связанных событиях. Это сокращает необходимость повторно передавать ей необработанную историю взаимодействия с компьютером.

Проактивное принятие решений

Проактивность реализована как отдельная задача принятия решений поверх контекстной памяти.

Система оценивает текущее состояние задачи, изменения контекста, потенциальную полезность помощи и стоимость прерывания пользователя.

Доступные решения включают подготовку информации, предложение действия, уведомление и отсутствие вмешательства.

LLM используется для интерпретации контекста, формирования предложений и планирования дальнейших шагов. Решение о необходимости инициативы не сводится к генерации очередного сообщения языковой моделью.

Обратная связь пользователя учитывается при последующих решениях, позволяя адаптировать поведение ассистента.

Границы самостоятельности

MOSS разделяет четыре уровня взаимодействия: наблюдение, интерпретацию, предложение и выполнение.

Распознанное намерение не считается подтверждённым поручением. Доступ к файлу не означает разрешения изменять его. Высокая уверенность модели не заменяет согласие пользователя.

Система сохраняет неопределённость выводов, предоставляет возможность исправлять ошибочные связи между задачами и учитывает установленные пользователем разрешения.

Технический разбор / Techcard

FORMA

Как предсказать решения технолога, не имея самого макета?

ML-система для подготовки технологических карт флексопечати. По данным заказа из 1С предсказывает расстановку красок на восьмицветной машине, анилоксы, монтажные ленты и необходимость ракельных камер.

Цель

Автоматизировать подготовку технологических карт, сократить ручную работу технологов и снизить риск ошибок в параметрах печати.

Исторические данные для supervised learning были в 1С: фактические расстановки красок, настройки оборудования и другие решения технологов. Но у этого датасета было серьёзное ограничение. Модель не видела сам макет, геометрию плашек, распределение красочного слоя и полный план производства — существенную часть информации, на которую опирался человек.

Фактически требовалось аппроксимировать историческую политику принятия решений по неполному контексту заказа.

Архитектура и эксперименты

Я разделил подготовку техкарты на несколько ML-задач: назначение станций для Spot-красок, подбор анилоксов и монтажных лент, определение необходимости ракельных камер.

Расстановка красок — не обычная независимая классификация. Для одного заказа нужно получить согласованную конфигурацию всей машины: нельзя назначить двум краскам одну физическую секцию. Поэтому сначала модель оценивает предпочтительные позиции, а затем оптимизационный алгоритм формирует совместную расстановку.

Сравнивал CatBoost, TabICL и TabICLv2, экспериментировал с признаками текущего заказа и историческим контекстом. Для нескольких целевых задач TabICLv2 оказалась предпочтительнее CatBoost и вошла в итоговый комплект.

Отдельно проверял гипотезу о пользе предыдущих техкарт. Результат оказался неочевидным: в одном A/B-эксперименте усложнённая история снизила exact accuracy для Spot-станций с 82,37% до 81,81%, одновременно резко увеличив время прогона. В финальной конфигурации остались признаки, доступные на момент поступления текущего заказа.

Для камер потребовался иной критерий качества. Пропуск нужной ракельной камеры нежелательнее лишней рекомендации, поэтому модели CatBoost отбирались с приоритетом recall. Spot- и процессные краски обрабатываются отдельными моделями, затем назначения согласуются с доступной ёмкостью двух групп секций.

Качество оценивал по-разному: exact и ±1 станция для расстановки, MAE для анилоксов, recall и precision для камер. Гиперпараметры подбирал через Optuna. Это были разные задачи с разной ценой ошибки, поэтому свести их к одной общей accuracy было бы бессмысленно.

Почему часть решений осталась детерминированной

Одна из наиболее дорогих ошибок связана с неправильным направлением печати. По нашей производственной оценке, ошибка на одном заказе может стоить порядка 100 тысяч рублей простоя.

Для этого параметра я использовал детерминированную логику на Python. Если направление можно вычислить по технологическим правилам, нет смысла заменять такое вычисление вероятностной моделью. С экономической точки зрения предотвращение подобных ошибок может быть важнее небольшого прироста offline-метрик.

Результат

Собрал production inference-сервис, принимающий данные заказов из 1С. В финальном комплекте пять моделей: три на TabICLv2 и две на CatBoost. Система формирует рекомендации по технологическим параметрам для восьмицветной флексомашины.

Проект объединил tabular ML, constrained assignment, исследование частично наблюдаемых производственных решений и детерминированную технологическую логику.

Стек: Python, TabICLv2, CatBoost, Optuna, SciPy, SQL Server, 1С, FastAPI.

AI / ML Engineer

Обо мне

Я AI/ML-инженер. Основные направления — computer vision, табличный ML, обработка речи, семантический поиск и LLM-агенты.

Мне интересны задачи с технической неопределённостью: неполные данные, отсутствие очевидного решения и модели, которым пока не хватает качества.

Работаю со всем циклом: исследование данных, baseline и сравнение моделей, inference API, интеграции, интерфейсы и инфраструктура. Довожу результат исследования до приложения, которым будут пользоваться люди.

Обсудить задачу

Контакт

Давайте обсудим
задачу

AI-системы, машинное зрение, поиск и аналитика.

Telegram @maintaggGitHub averagedigitalHugging Face average23

Технический разбор

CVmap

От детекции людей к аналитике их перемещения

Система видеоаналитики производства: детекция людей, multi-object tracking, spaghetti tracking, ReID, тепловые карты, события пересечения линий, анализ зон и сменные отчёты.

Цель

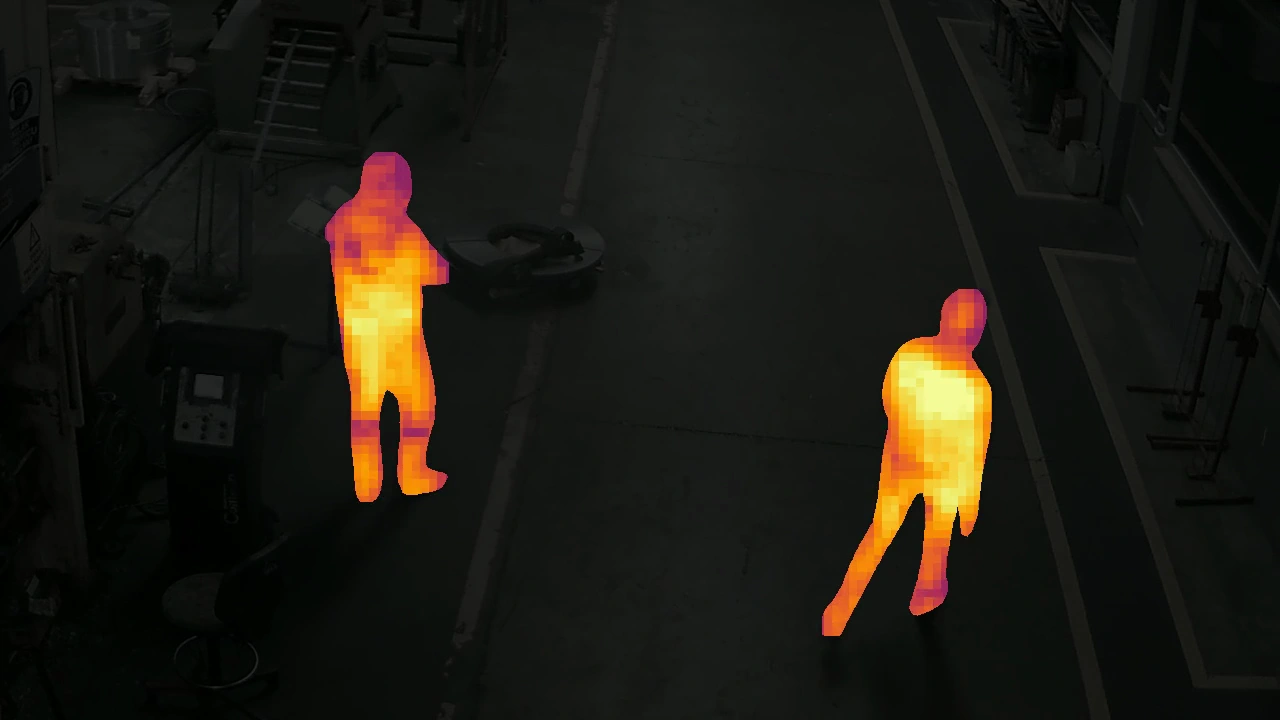
Превратить потоки с камер наблюдения в структурированные данные о движении людей на производстве: присутствие в зонах, посещения, маршруты, пересечения контрольных линий и интенсивность перемещений.

Видеопайплайн

Основной GPU-контур построил на NVIDIA DeepStream 8.0. PeopleNet отвечает за детекцию, NvDCF — за сопровождение объектов. Поверх локальных треков рассчитываются события, временные ряды присутствия, heatmaps и статистика зон.

Отдельно реализовал spaghetti tracking: накопленные траектории отображаются поверх видеопотока. Можно посмотреть, как люди перемещались по наблюдаемому пространству в течение последнего часа, где чаще проходили и какие участки использовали.

ReID и проблема идентичности

Локальный track_id не равен идентичности человека. После выхода из кадра и возвращения трекер может создать новый идентификатор. При наблюдении с нескольких камер эта проблема становится ещё сложнее.

Для повторного сопоставления tracklets я разработал дополнительный ReID-контур. Body embeddings дают оценку визуального сходства, но одного cosine similarity недостаточно: сотрудники могут быть одеты одинаково.

Поэтому matching учитывает также время, интервалы присутствия, пространственную совместимость и разрешённые переходы между камерами. Кандидаты проходят ограничения, затем выбираются с помощью Hungarian assignment.

При неоднозначном сопоставлении система может оставить два отдельных идентификатора вместо ложного объединения.

Отдельно предусмотрено распознавание лиц через YuNet/SFace.

Продуктовый слой

Реализовал backend и браузерный интерфейс для работы с камерами и зонами, просмотра потока с разметкой, включения траекторий, исследования событий и подготовки сменных отчётов.

Результат

CVmap объединяет видеодетекцию, multi-object tracking, опциональный ReID и прикладную аналитику в одном продукте.

Основная инженерная сложность — переход от последовательности кадров к событиям и траекториям с осмысленной идентичностью.

Стек: NVIDIA DeepStream 8.0, TensorRT, PeopleNet, NvDCF, OpenVINO, ReID, YuNet, SFace, Python, FastAPI, PostgreSQL, React, TypeScript.

Обсудить задачу

Технический разбор

AudioAnaliz

От телефонной записи к структурированной аналитике

Система обработки телефонных разговоров: ASR, diarization, speaker identification и LLM-анализ. Распознаёт речь, определяет участников, проверяет содержание по заданным критериям и формирует отчёты с привязкой к исходному аудио.

Цель

Автоматизировать анализ телефонных переговоров и превратить записи в структурированные данные для контроля договорённостей, качества коммуникации и регулярной отчётности.

Для этого потребовалось объединить несколько ML-задач: speech recognition, diarization, speaker identification и семантический анализ разговора.

Выбор ASR

Начинал с экспериментов с Whisper и WhisperX. На реальных телефонных записях качество оказалось неоднородным: шум, короткие реплики и особенности каналов иногда приводили к пропускам и галлюцинациям текста.

После сравнительных прогонов основным ASR выбрал GigaAM v3 e2e RNN-T. Для выделения речи использую pyannote VAD, а word-level timestamps позволяют сопоставлять текст с исходной записью.

Stereo-записи обрабатываются по каналам. Для mono применяется диаризация, чтобы разделять реплики участников внутри одного аудиопотока.

Diarization не равна identification

Диаризация определяет, какие реплики принадлежат одному голосу в пределах звонка. Но для корпоративной аналитики часто нужно установить конкретного сотрудника.

Для этого я построил speaker identification pipeline на embeddings NeMo TitaNet, галерее эталонных голосов, k-NN и дополнительных оценках сходства.

Важное ограничение — качество enrollment data. Если в голосовой эталон попадут реплики клиента, эмбеддинги перестанут надёжно представлять нужного сотрудника. Поэтому для отбора образцов понадобился отдельный процесс проверки и подготовки чистых голосовых сегментов.

LLM-анализ и отчёты

После распознавания транскрипт передаётся LLM для анализа по конкретным критериям: договорённости, факт уведомления клиента, выполненные и пропущенные действия, подтверждающие реплики.

Результаты анализа привязываются к фрагментам транскрипта, которые можно проверить по записи.

Интерактивный HTML-отчёт объединяет участников, текст, временные отметки и выводы. Пользователь может перейти к нужной реплике и проверить основание для заключения.

Интеграция в бизнес-процессы

Отдельный сценарий использует звонки из Bitrix24. Через Airflow собираются записи и контекст CRM, после чего результаты ASR и LLM-анализа сопоставляются с клиентами, сотрудниками и данными 1С.

Например, можно проверять, сообщил ли менеджер клиенту необходимую информацию, и собирать сводную аналитику по обработанной выборке звонков.

Результат

Система объединяет VAD, ASR, diarization, speaker identification и LLM-based quality analysis в один pipeline.

Стек: Python, PyTorch, GigaAM v3, pyannote, NeMo TitaNet, k-NN, PLDA, LLM, FastAPI, Airflow, Bitrix24.

Демонстрация SONAR

На главной странице — фрагмент интервью А. Н. Иванова на MediaMetrics от 19 сентября 2017 года. Автор публикации: Alexey Arkhipov. Оригинальная запись · CC0 1.0. Использован отрывок 1:24.70–1:52.15, аудио сокращено и перекодировано.

Обсудить задачу

Технический разбор

ATLAS

Собственный индекс для корпоративных файлов

Локальный поисковый движок на Rust: полнотекстовый и семантический поиск по корпоративным файлам, SQLite FTS5, векторный индекс и серверный inference на EmbeddingGemma 2. Поддерживаются офисные документы, PDF и мультимедийные материалы.
Цель

Дать возможность искать корпоративные документы по содержанию, а не только по названиям и расположению файлов.

Дополнительное требование — не размещать тяжёлые модели на компьютере каждого сотрудника. Индекс и доступ к файлам должны оставаться локальными, а ML-инференс — централизованным.

Собственный индексатор

Для Windows-клиента я разработал поисковый слой на Rust. Он обходит разрешённые каталоги, извлекает содержимое документов, разбивает данные на фрагменты и обновляет индекс при изменении исходных файлов.

В качестве локального хранилища использовал SQLite. FTS5 отвечает за лексический поиск, sqlite-vec хранит 768-мерные embeddings и выполняет vector similarity search.

Оба режима используют общий каталог файлов и метаданных. Пользователь может искать точную формулировку или близкие по смыслу фрагменты.
Разделение локальной и серверной обработки

Векторизация вынесена на корпоративный сервер с EmbeddingGemma 2. Это избавляет пользовательские компьютеры от необходимости запускать собственную модель и упрощает управление inference-инфраструктурой.
Локальный компонент отвечает за файловый scope, индекс, очередь обработки и retrieval. Сервер выполняет вычисления для документов и поисковых запросов. Векторы сохраняются на стороне клиента.

Для разных форматов используется подходящий способ извлечения содержимого. Текст офисных файлов можно обрабатывать структурно, PDF без текстового слоя и изображения требуют визуального анализа, а аудио и видео разбиваются на фрагменты для последующей модельной обработки.

Производительность и контроль доступа

Поисковый запрос не должен ждать переиндексации всего каталога. Поэтому обновление индекса выполняется отдельно, а вычисленные embeddings повторно используются, пока исходные данные не изменятся.

Ориентир для серверного inference поискового запроса — около 120 мс.

Результат

Собственный поисковый движок, встроенный в Windows-клиент: индекс, полнотекстовый и семантический retrieval, работа с разными форматами и серверный inference.

Для меня этот проект интересен на стыке Rust, поисковых структур, мультимодальной обработки и архитектуры распределённого ML-сервиса.

Стек: Rust, SQLite, FTS5, sqlite-vec, EmbeddingGemma 2, vector search, Tauri, React, TypeScript.

ATLAS: записанный мультимодальный эксперимент

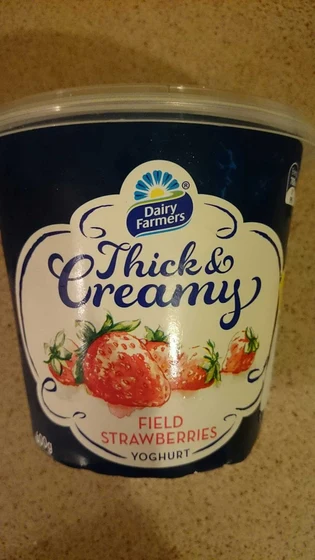
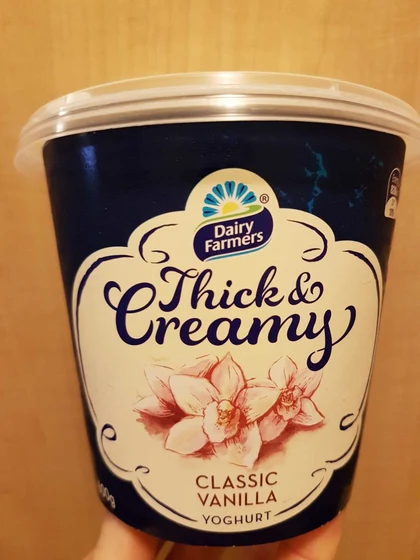
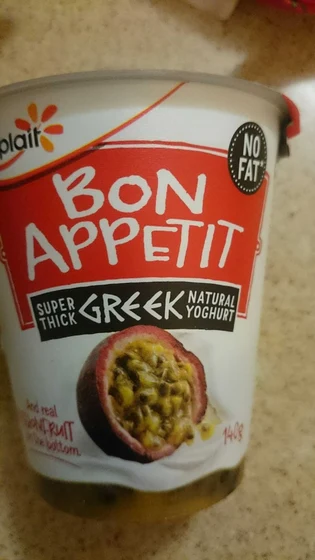
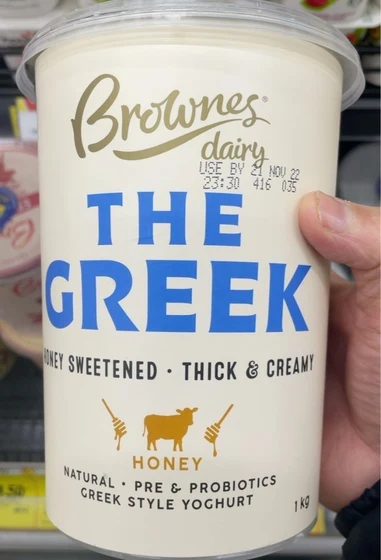
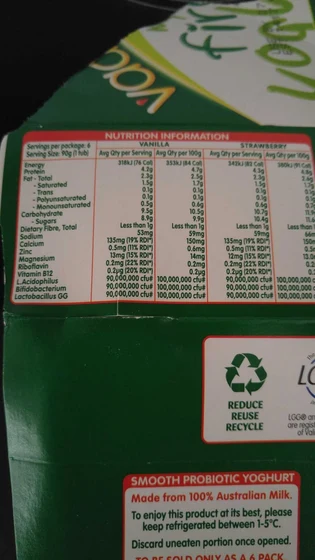
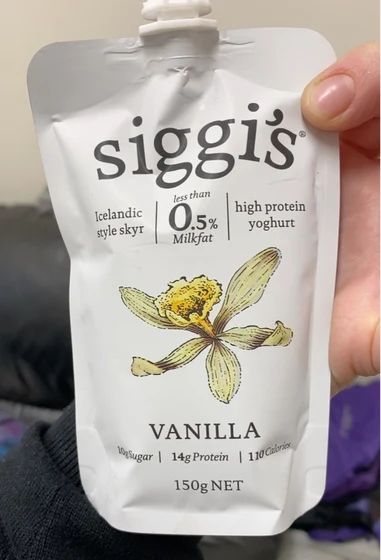
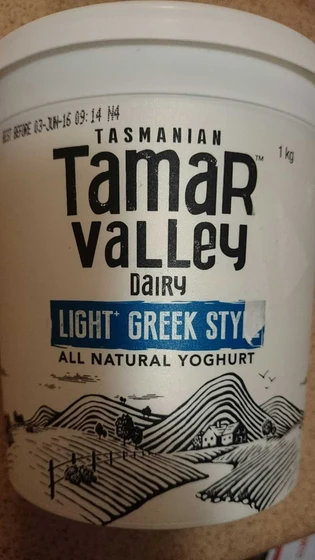
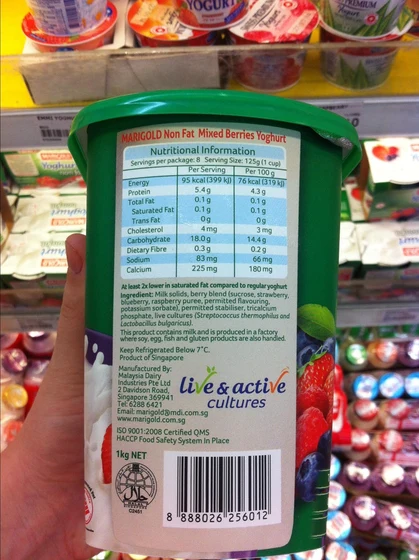
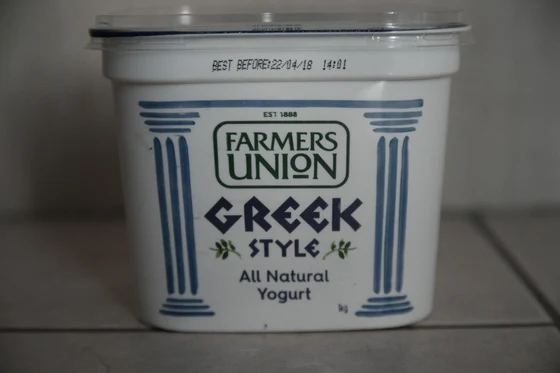
Демо воспроизводит четыре сохранённых запроса по 39 файлам: 15 фотографиям упаковок и 24 текстовым отрывкам в PDF, DOCX и TXT. EmbeddingGemma 2 кодирует изображения непосредственно и сопоставляет их с русским запросом в общем 768-мерном пространстве. Использован квантованный runtime: текст Q4_K_XL, vision Q8_0.

Сохранены реальные токены, компоненты вектора, cosine similarity и ранги sqlite-vec. FTS5 выполняется по аннотациям изображений и тексту документов; его выдача сохранена в trace, но не занимает место в визуальной сцене. Карточки размещены композиционно, а не по PCA. Три кандидата и их порядок определены реальными cosine scores. Числовой фрагмент показывает первые 32 компоненты настоящего вектора; вычисление ранга использует все 768.

Дополнительные документы — конвертированные отрывки из Alice in Wonderland Льюиса Кэрролла и Sherlock Holmes Артура Конан Дойла, Project Gutenberg (public domain in USA).

Данные: Food Packaging OCR Dataset v2, Chia Zi Qi, CC BY 4.0.

Обсудить задачу

Технический разбор

ARGUS

Как обнаруживать микродефекты на макетах без сотен ложных срабатываний?

Система компьютерного зрения для проверки дизайн-макетов перед печатью. Сравнивает изображения, находит пропавшие элементы, смещения и другие изменения. Отдельный контур проверяет текст, орфографию и коды без эталонного изображения.

Цель

Автоматизировать визуальный контроль макетов упаковки и обнаруживать даже небольшие, но значимые изменения: потерянные символы, смещения, нарушения контуров и ошибки отдельных элементов дизайна.

Критерий успеха — не максимальный pixel recall. Нужна высокая чувствительность при приемлемом числе ложных замечаний на один макет.

Архитектура

Простое сравнение пикселей плохо переносит различия в масштабе, растеризации, сглаживании шрифтов и геометрии изображений. Эти расхождения могут визуально напоминать настоящие дефекты.

Поэтому я построил парный visual change detection pipeline: геометрическое совмещение изображений, извлечение признаков через DINOv3 и обучаемый HR-SiamFPN head для построения карты изменений.

Инференс выполняется по перекрывающимся фрагментам исходного разрешения. Для упаковочных макетов это принципиально: при уменьшении всей страницы микродефект может перестать существовать в пространстве признаков.

Что показали эксперименты

Один из исследовательских запусков достиг region recall около 82%, но одновременно давал примерно 1,01 ложного региона на макет при целевом бюджете не более 0,25. При таком соотношении даже хорошая чувствительность не делает систему удобной для дизайнера.

Выяснилось, что pixel-level оптимизация и итоговая region-level оценка могут расходиться. При уменьшении бинарной GT-маски методом nearest neighbor дефекты размером 1–3 пикселя иногда полностью исчезали из supervision. А один дефект из нескольких раздельных компонентов мог некорректно оцениваться как несколько независимых событий.

Я переработал подготовку supervision и оценку: сохранение позитивных пикселей при downsampling, сопоставление регионов по реальным экземплярам изменений, отдельные показатели для мелких дефектов и контроль false positives per layout.

Для рабочего visual-diff контура в дальнейшем использовал более компактный DINOv3 ConvNeXt Tiny.

Второй контур: Text QC

Проверка текста работает независимо от сравнения двух изображений. Она принимает отдельный макет и ищет смысловые, орфографические и другие подозрительные ошибки.

Для растрового текста используются YOLO и Surya OCR 2; PDF с текстовым слоем обрабатываются с сохранением исходной геометрии. LLM анализирует извлечённое содержимое, а backend сопоставляет замечания с реальными текстовыми элементами и их координатами. Модель не назначает произвольные bounding boxes.

Так можно подсветить проблему непосредственно на макете и показать, на каком фрагменте основано замечание.

Результат

Synoplex объединяет два самостоятельных сценария: visual change detection по паре макетов и AI-проверку текста по одному документу.

Самая интересная часть проекта — перевод задачи из «сравнить две картинки» в измеримый контроль реальных дефектов с явным бюджетом ложных срабатываний.

Стек: Python, PyTorch, DINOv3, ConvNeXt Tiny, HR-SiamFPN, OpenCV, YOLO, Surya OCR 2, LLM, Flask, Celery.

Демонстрация ARGUS

ARGUS продолжает выбранный запрос ATLAS: найденная фотография проходит через текстовые области, OCR, смысловое замечание, признаки DINOv3 и сравнение изображений.

Text QC использует сохранённые YOLO/Surya/LLM-результаты. Для трёх случаев подготовлены изменённые версии этикеток; координаты относятся к этим версиям. Карта DINO вычислена по оригиналу через encoder Synoplex, а её цвет — общая трёхкомпонентная проекция признаков четырёх изображений.

Исходные фотографии: Food Packaging OCR Dataset v2, Chia Zi Qi, CC BY 4.0. В демонстрации использованы производные изображения.

Обсудить задачу